# 14 KI: Schlüssel und Modelle
Das CRM ruft OpenAI an drei Stellen auf. Schlüssel und Modell pflegen
Administratoren unter **Einstellungen → KI** - ohne SSH, ohne Neustart.
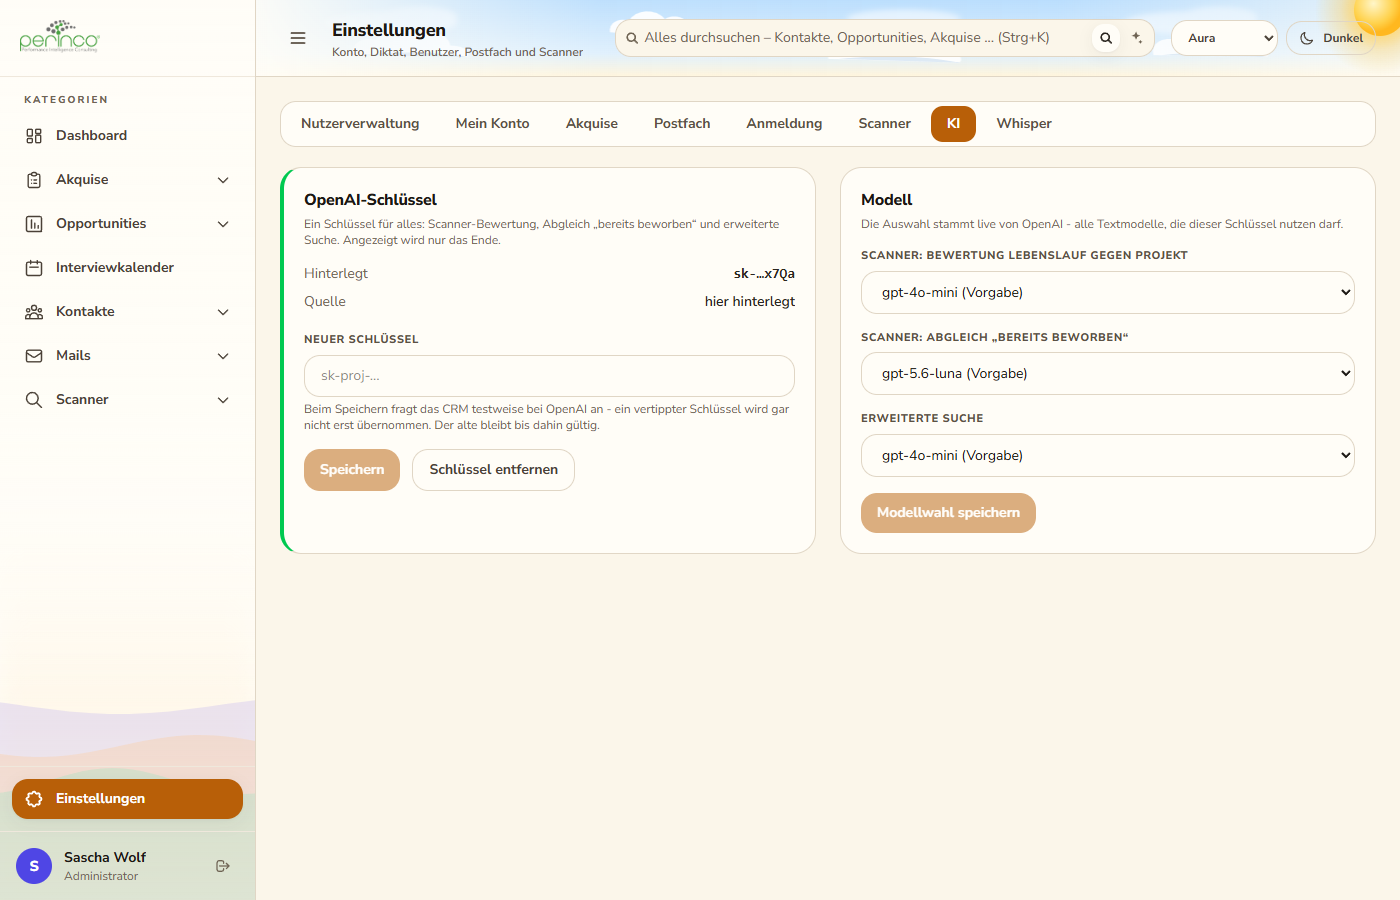
## Wo die KI arbeitet
| Einsatzzweck | Code | Schlüssel in `crm_settings` | Vorgabe |
| --- | --- | --- | --- |
| Scanner: Bewertung Lebenslauf gegen Projekt | `scanner/services/matchingEngine.js` | `ai_model_matching` | `gpt-4o-mini` |
| Scanner: Abgleich „bereits beworben" | `scanner/services/appliedCheck.js` | `ai_model_applied` | `gpt-5.6-luna` |
| Erweiterte Suche | `routes/search.js` | `ai_model_search` | `gpt-4o-mini` (bzw. `OPENAI_MODEL`) |
Die Vorgaben sind genau die Modelle, die vor der Einstellung fest im Code
standen. Wer nichts umstellt, merkt also nichts. Steht in `crm_settings` kein
oder ein ungültiger Eintrag, gilt die Vorgabe.
```mermaid
flowchart LR
UI["Einstellungen → KI"] -->|"PUT /api/ai/key"| V{"GET /v1/models
mit neuem Schlüssel"}
V -->|"abgelehnt"| X["Fehlermeldung,
alter Schlüssel bleibt"]
V -->|"ok"| K[("perinco_scanner.settings
openai_api_key")]
UI -->|"PUT /api/ai/models"| M[("perinco_CRM.crm_settings
ai_model_*")]
K --> AI["server/src/ai.js
aiKey() / modelFor()"]
E["OPENAI_API_KEY
server/.env"] -.->|"nur wenn DB leer"| AI
M --> AI
AI --> S1["Scanner-Bewertung"]
AI --> S2["Abgleich bereits beworben"]
AI --> S3["Erweiterte Suche"]
```
## Schlüssel
Es gibt **genau einen** OpenAI-Schlüssel für Scanner und CRM. Er liegt
unverändert als `openai_api_key` in der Scanner-Tabelle `settings` - dort, wo er
schon immer lag. Nichts musste umziehen. Ersatzweise gilt `OPENAI_API_KEY` aus
`server/.env`.
* **Anzeige nur mit Ende.** Die Oberfläche zeigt `sk-…` und die letzten vier
Zeichen, dazu die Quelle (*hier hinterlegt* oder *server/.env*). Mehr gibt der
Server nie heraus, auch nicht an Administratoren. Bei Schlüsseln unter zwölf
Zeichen steht nur *ja*.
* **Vor dem Speichern geprüft.** Ein neuer Schlüssel wird erst gegen
`GET https://api.openai.com/v1/models` ausprobiert. Lehnt OpenAI ab, bleibt der
alte gültig, und die Meldung von OpenAI steht im Fehlertext. Der Abruf kostet
nichts.
* **Verwerfen** leert den hinterlegten Wert. Danach gilt wieder die `.env` -
oder, wenn dort nichts steht, gibt es keinen Schlüssel mehr.
* Der Schlüssel liegt **unverschlüsselt** in der Scanner-Datenbank, wie bisher.
Ein Dump von `perinco_scanner` enthält ihn also.
Im Reiter *Scanner* gibt es kein Schlüsselfeld mehr. `POST /api/scanner/settings`
nimmt `openai_api_key` aus Kompatibilität weiter an.
## Modelle
Das Dropdown füllt sich **live von OpenAI**: alle Modelle, die der Schlüssel
nutzen darf, gefiltert auf Textmodelle (`gpt-*`, `o1`/`o3`/`o4…`, `chatgpt-*`,
ohne Audio, Bild, Embedding, Realtime, TTS, Suche, Moderation). Die aktuell
eingestellten Modelle stehen immer mit drin, die Vorgabe ist markiert.
Ist die Liste nicht abrufbar (kein Schlüssel, OpenAI nicht erreichbar), zeigt
das Dropdown eine feste Auswahl, und die Seite sagt, warum.
Die Wahl gilt ab dem nächsten Aufruf - es gibt keinen Zwischenspeicher.
### Reasoning- und klassische Modelle
Die beiden Modellfamilien nehmen unterschiedliche Parameter. Damit ein Wechsel
im Dropdown keinen `400` von OpenAI auslöst, entscheidet `isReasoningModel()`
(Namen `o1…`, `o3…`, `gpt-5…`, `gpt-6…` und jede spätere Generation) je Aufruf:
| | Reasoning (`o*`, `gpt-5*`, `gpt-6*` …) | klassisch (`gpt-4o*`, `gpt-4.1*`) |
| --- | --- | --- |
| Scanner-Bewertung | `reasoning_effort: low` | `temperature: 0.1` |
| Abgleich „bereits beworben" | `reasoning_effort: low` | `temperature: 0` |
| Erweiterte Suche | `max_completion_tokens` | `max_completion_tokens` |
`max_completion_tokens` verstehen beide Familien, das alte `max_tokens` die
Reasoning-Modelle nicht.
Bis zum 24.09.2026 erkannte das Muster nur `gpt-5…`. `gpt-6-luna` galt damit als
klassisch, bekam `temperature: 0.1` und OpenAI lehnte jeden Aufruf ab
(„Only the default (1) value is supported"). Deshalb zählt jetzt jede Generation
ab 5 als Reasoning-Modell.
**Vergleich Scanner-Bewertung, 24.09.2026** (33 echte Projekte aus Lisa, Ariane
und Tobias, neuer Bewertungsprompt, siehe [03 Scanner](03-scanner.md#bewertungsprompt)):
| | `gpt-4o-mini` | `gpt-6-luna` (`reasoning_effort: low`) |
| --- | --- | --- |
| Fehler | 0 | 0 |
| Ø Antwortzeit | 1,3 s | 2,8 s |
| Ø Token rein / raus | 5337 / 108 | 5336 / 172 (davon 35 Reasoning) |
| passende Rollen | 85-95 | 82-98 |
| fachfremde Rollen | meist 0 oder 30 | 0-15, feiner abgestuft |
| Preis je 1 Mio. Token rein / raus (Standard, Stand 24.09.2026) | 0,15 $ / 0,60 $ | 0,10 $ / 0,50 $ |
| Kosten je Bewertung (ohne Cache) | 0,087 ct $ | 0,062 ct $ |
| hochgerechnet auf ~9 500 Bewertungen je Woche | ~8,20 $ | ~5,90 $ |
Luna ist also rund 28 % günstiger, obwohl es mehr Token ausgibt: die Eingabe
(Prompt plus Lebenslauf, rund 5 300 Token) macht über 90 % der Kosten aus, und
die ist bei Luna billiger. Gecachte Eingabe kostet bei Luna 0,01 $ statt
0,075 $ je 1 Mio. Token - Systemprompt und Lebenslauf stehen am Anfang jeder
Anfrage eines Agenten, das Einsparpotenzial ist dort also noch größer.
Luna begründet genauer und bleibt nah am Lebenslauf. Grenzfälle
(übertragbare Erfahrung) bewertet es spürbar großzügiger als `gpt-4o-mini`.
## Endpunkte
Alle unter `/api/ai`, nur für Administratoren.
| Methode | Pfad | Zweck |
| --- | --- | --- |
| GET | `/settings` | Schlüsselzustand, Modell je Zweck, Auswahlliste |
| PUT | `/key` | `{ key }` - prüfen, dann speichern |
| DELETE | `/key` | hinterlegten Schlüssel verwerfen |
| PUT | `/models` | `{ matching?, applied?, search? }` - Namen geprüft gegen `^[A-Za-z0-9][A-Za-z0-9._:-]{0,99}$` |
## Dateien
| Datei | Aufgabe |
| --- | --- |
| `server/src/ai.js` | Schlüssel, Modellwahl, Modellliste, Aufruf der Suche |
| `server/src/routes/ai.js` | die vier Endpunkte |
| `src/components/settings/AiSettings.tsx` | Reiter *KI* |
| `server/test/ai.test.mjs` | Modellnamen und Reasoning-Erkennung |